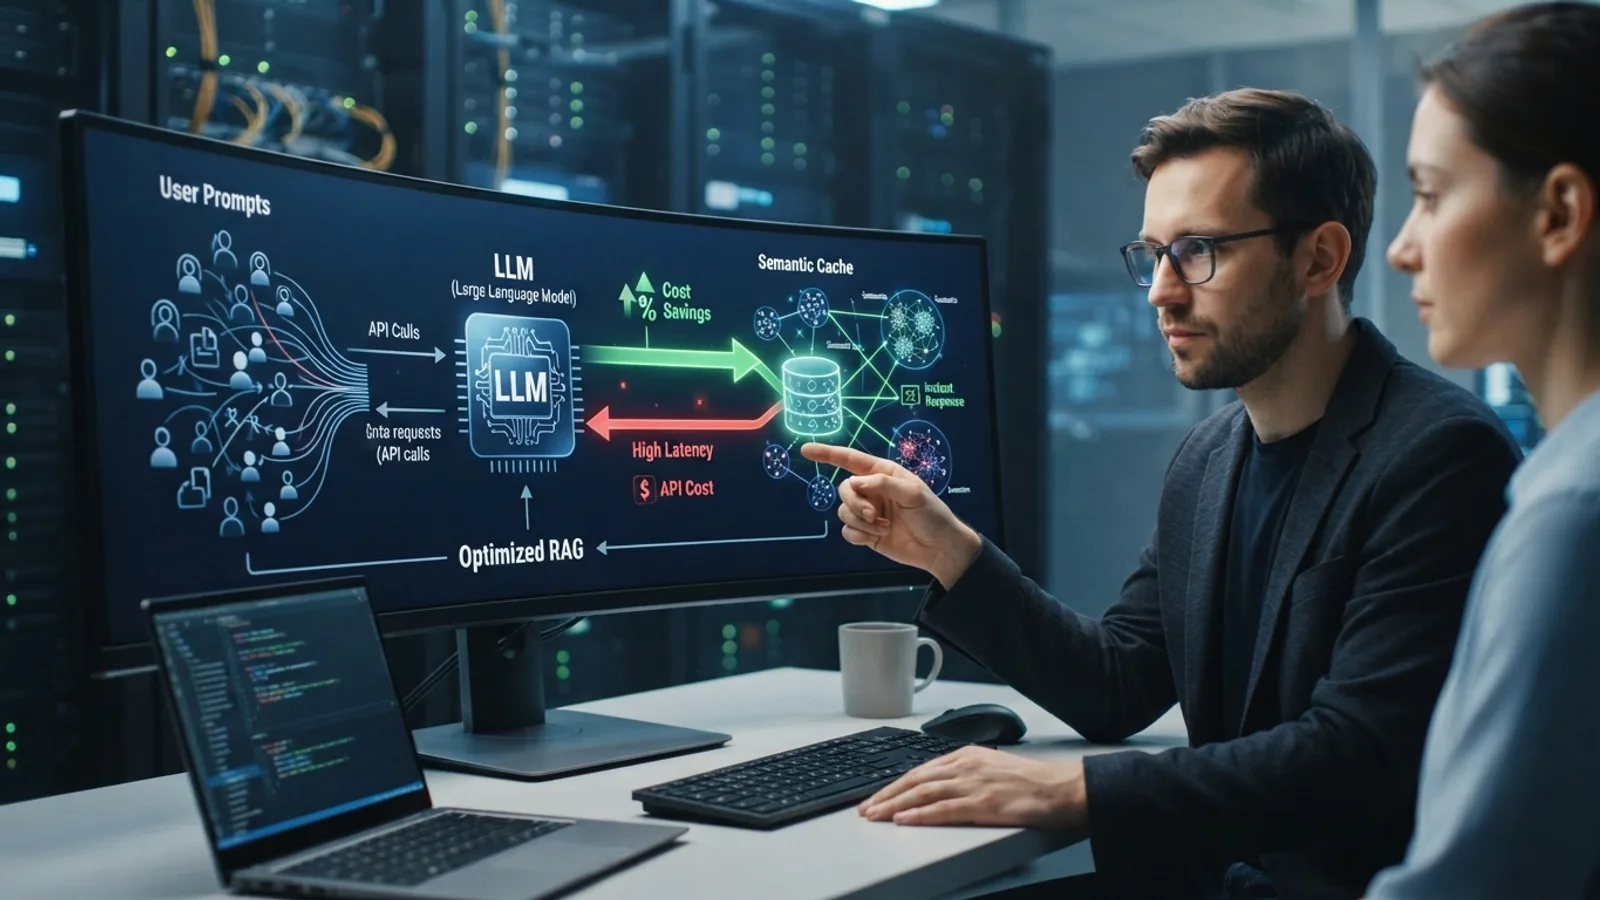
O dilema da escalabilidade: O custo oculto da inferência em sistemas RAG
À medida que empresas integram modelos de linguagem (LLMs) em seus fluxos de trabalho, a escala traz um desafio crítico: o custo operacional por consulta. Em arquiteturas de Geração Aumentada por Recuperação (RAG), cada interação dispara chamadas sequenciais para modelos fundacionais, o que resulta em despesas que crescem linearmente com o volume de usuários. Além do impacto financeiro, o processamento contínuo de consultas idênticas ou semanticamente similares gera uma latência desnecessária, comprometendo a experiência final do usuário.
A ineficiência reside no tratamento de cada requisição como um evento inédito, ignorando padrões de comportamento. Para CTOs e gestores de inovação, a busca por escala exige uma mudança de paradigma: sair da computação puramente reativa para um modelo de inteligência orquestrada, onde a tecnologia de cache atua como a primeira linha de defesa contra o consumo descontrolado de tokens de API.
Arquitetura de Cache Híbrido: O melhor dos dois mundos
A solução para esse cenário é a implementação de um sistema de cache híbrido, que combina dois mecanismos distintos para cobrir diferentes necessidades de processamento:
- Cache Exato (Key-Value): Utiliza o hash da consulta de entrada para identificar requisições idênticas. É ideal para perguntas recorrentes de usuários e oferece latência na casa dos milissegundos, eliminando qualquer custo de inferência ou embedding para esses casos.
- Cache Semântico (Vetorial): Utiliza busca por similaridade através de embeddings. Diferente do cache exato, este identifica quando a intenção de duas consultas é a mesma, mesmo que a formulação textual seja diferente. Isso permite que o sistema entregue respostas aprendidas anteriormente para variações da mesma pergunta, economizando recursos computacionais preciosos.
Essa abordagem permite que o sistema decida, de forma granular, se uma consulta deve seguir o pipeline completo de RAG ou se pode ser resolvida instantaneamente pelo cache, garantindo uma economia substancial sem comprometer a qualidade da resposta.
Estratégias de implementação: De embeddings a limiares de similaridade
Não basta armazenar dados; é necessário implementar inteligência na camada de recuperação. A engenharia de um cache semântico eficaz exige critérios técnicos rigorosos:
- Ajuste de Limiar de Cosseno: Definir a sensibilidade do cache. Um limiar muito alto pode causar falsos negativos, forçando chamadas desnecessárias à API. Um limiar muito baixo pode retornar respostas contextualmente imprecisas.
- Particionamento por Metadados: Essencial para garantir a segurança e o isolamento de informações em ambientes multitenant. Utilizar metadados permite que o sistema filtre o cache apenas para as permissões ou domínios específicos do usuário, evitando o vazamento de informações entre diferentes contextos de negócio.
Desafios de governança e integridade dos dados
Manter o cache atualizado em sistemas dinâmicos é um dos maiores desafios de engenharia. Quando a base de conhecimento do RAG é atualizada, o cache semântico corre o risco de servir respostas defasadas. Estratégias robustas incluem políticas de TTL (Time-To-Live) configuráveis, invalidação seletiva baseada em eventos de atualização de dados e a implementação de mecanismos de versionamento de contextos.
FAQ: Perguntas frequentes sobre otimização de custos em IA
- Como a invalidação de cache impacta a performance? A invalidação deve ser tratada como um processo assíncrono para garantir que a experiência do usuário não sofra degradação enquanto o cache é atualizado com novas informações da base de conhecimento.
- Qual é o impacto real na redução de custos? Em cenários corporativos com alta repetição de padrões de consulta, observamos reduções que podem chegar a 80% nos custos de inferência, além da redução drástica no tempo de resposta das aplicações.
- A qualidade da resposta diminui com o uso de cache? Não, desde que a governança do limiar de similaridade seja bem calibrada. O cache deve ser considerado uma extensão da inteligência do LLM, não um substituto para a precisão técnica.
Transformando eficiência tecnológica em resultado de negócio
A aplicação de arquiteturas de cache híbrido é um exemplo claro de como a Caristeo Tecnologia combina engenharia avançada com visão estratégica. Não entregamos apenas software, mas produtos digitais preparados para o crescimento, onde a eficiência técnica se traduz diretamente em escalabilidade econômica e competitividade.
Se você busca otimizar a performance de suas aplicações de IA ou integrar LLMs ao seu negócio com previsibilidade financeira, estamos prontos para atuar.