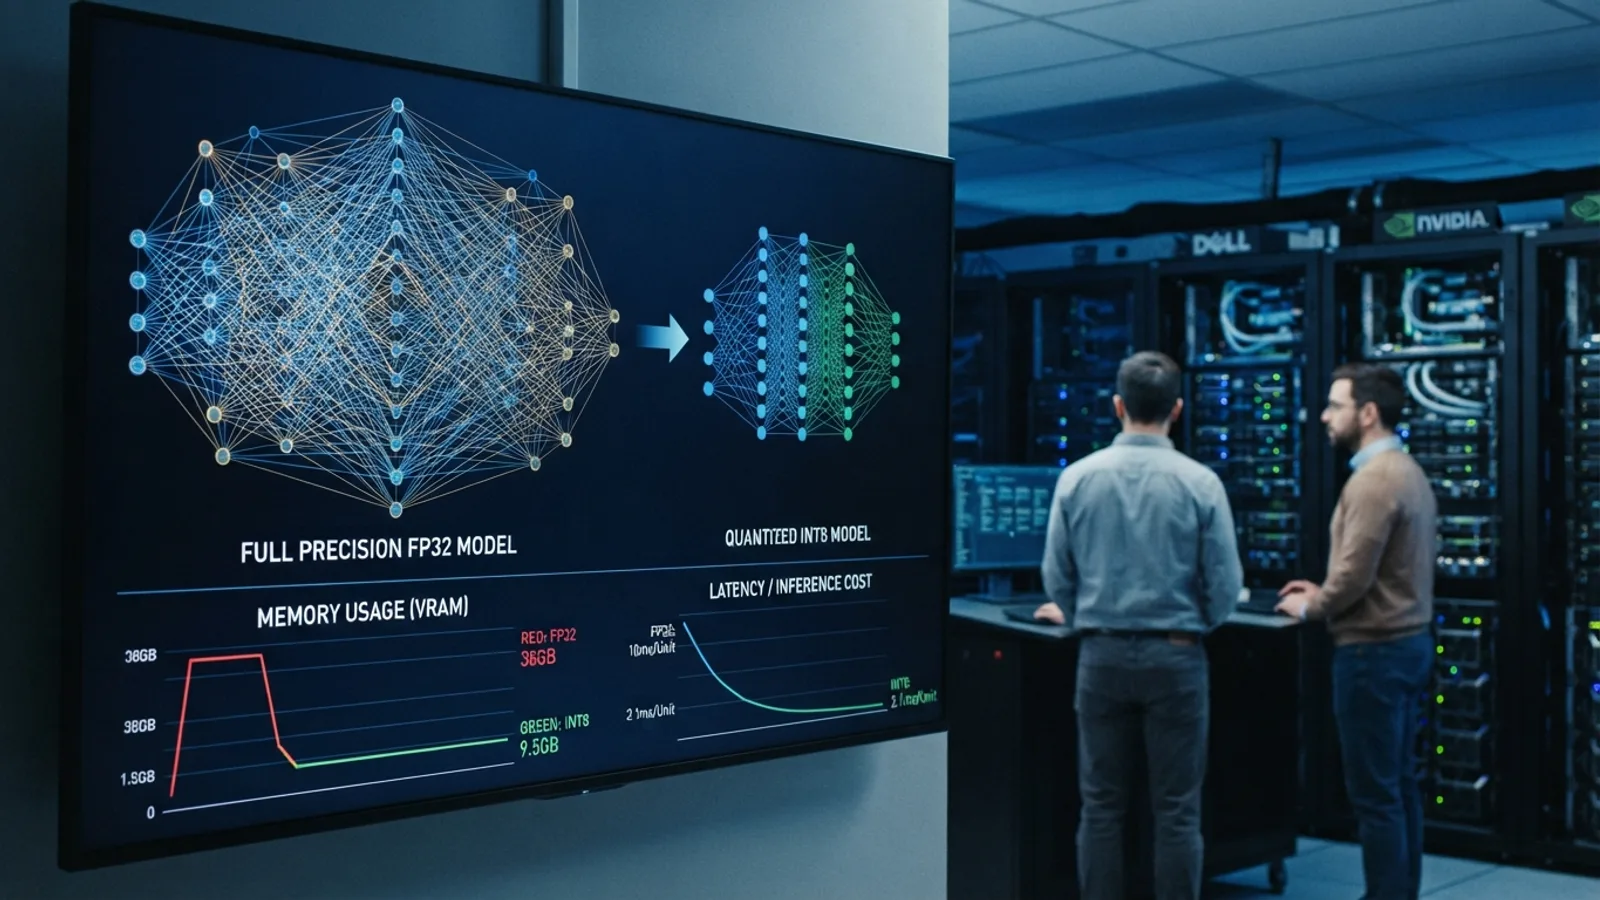
O desafio da escala: Por que a precisão nem sempre dita o sucesso em IA
No cenário atual de inteligência artificial corporativa, a capacidade de escalar modelos de linguagem de grande porte (LLMs) é um divisor de águas. Muitas vezes, empresas enfrentam gargalos críticos devido ao consumo excessivo de memória de vídeo (VRAM) e ao alto custo computacional por token gerado. A busca incessante por modelos com a maior precisão possível (FP16 ou BF16) frequentemente resulta em uma infraestrutura subutilizada e cara, que não justifica o ganho marginal de performance em aplicações de negócio. Para líderes de tecnologia e inovação, o desafio não é apenas manter a acurácia, mas garantir que a engenharia de IA sustente o crescimento do negócio com eficiência operacional.
Desmistificando a quantização de modelos de IA
A quantização de modelos de IA consiste em converter os pesos, ativações e o KV cache de formatos de alta precisão para representações de bits reduzidos, como INT8 ou FP8. Ao contrário do que se pode supor, essa técnica não degrada a performance de inferência de maneira proibitiva. O objetivo é aplicar métodos como a Quantização Pós-Treinamento (PTQ), que utiliza calibração estatística para ajustar fatores de escala sem a necessidade de um retreinamento completo e dispendioso. Isso permite que modelos complexos operem em hardwares com menor capacidade, mantendo o comportamento esperado para as tarefas de negócio.
Impacto real: VRAM, latência e a economia de escala
A adoção de formatos otimizados traz resultados mensuráveis para a arquitetura de sistemas:
- Redução significativa na pegada de VRAM: A quantização permite armazenar modelos maiores em GPUs com menor capacidade de memória.
- Aumento de throughput: A menor demanda de transferência de dados acelera o processo de inferência.
- Otimização do KV cache: Quantizar o cache de contexto em INT8 ou FP8 reduz o consumo de memória por requisição em até 50%, possibilitando a execução de maiores lotes concorrentes (batch size).
Estratégia de implantação: Quando optar por cada formato?
A escolha entre FP8 e INT8 deve ser pautada pela infraestrutura disponível e pelo rigor necessário da aplicação. O FP8 (especificamente o formato E4M3) tem se tornado um padrão moderno em hardwares com aceleração nativa, oferecendo ganhos de throughput entre 1,4x e 1,8x com perdas mínimas de acurácia. Já o INT8 é uma alternativa robusta para ambientes que exigem compatibilidade ampla, embora possa exigir camadas intermediárias de desquantização para manter a faixa dinâmica em modelos mais sensíveis.
Tolerância e Trade-offs: O limite aceitável de precisão
Determinar o limite aceitável de variação de precisão é uma decisão estratégica de produto. Nem todo caso de uso exige a precisão absoluta do FP16. Para muitas automações de processos, agentes de IA e interfaces de suporte, uma redução mínima de acurácia é imperceptível para o usuário final, enquanto a economia financeira em infraestrutura computacional pode ser expressiva. A engenharia de produto deve equilibrar o custo operacional total (TCO) com as metas de desempenho estabelecidas, tratando a quantização como um componente central da arquitetura de escala.
Perguntas frequentes
Como a quantização reduz o custo de inferência?
A quantização reduz a exigência de VRAM por modelo, permitindo que a empresa utilize instâncias de nuvem menores ou que processe mais requisições simultâneas na mesma infraestrutura, reduzindo drasticamente o custo por token gerado.
Existe perda de qualidade perceptível com o uso de INT8?
Em tarefas de uso geral e aplicações corporativas, a perda de qualidade é frequentemente desprezível. Com técnicas adequadas de calibração estatística, o modelo mantém a inteligência necessária para o negócio, otimizando recursos sem comprometer o resultado final.
O que é o KV cache e como sua quantização ajuda na performance?
O KV cache armazena estados anteriores da computação do modelo para acelerar a geração de texto. Sua quantização permite que o sistema mantenha janelas de contexto maiores por usuário, aumentando a capacidade do servidor sem a necessidade de adquirir hardware adicional.
A Caristeo pode ajudar a escalar minha infraestrutura de IA?
Sim. A Caristeo Tecnologia atua na engenharia e arquitetura de soluções de IA sob medida, ajudando empresas a implementar modelos otimizados que equilibram performance técnica e viabilidade financeira. Fale com a Caristeo para uma análise do seu cenário.
Fale com a Caristeo.